データエンジニアの採用方法|1人目に向く人と隣接職種の経験の扱い
データエンジニアの採用は、基盤の立ち上げ、データパイプラインの整備、品質と管理、機械学習の基盤のどれが必要かで要件が異なります。1人目には、基盤の技術に加えて、データを使う人の要望から優先順位を判断してきた人が向いています。
データエンジニアの採用では、基盤の立ち上げやデータパイプラインの整備など、任せる役割の型を決定してから経験者を探します。たとえば、経営会議で使う売上や解約の数字を、毎週だれかが複数のシステムから手作業で集めている場合、データエンジニアはその作業を、毎朝自動で更新される仕組みに置き換えます。
データエンジニアは、分析や機械学習に使うデータを集めて整え、使う人に届ける職種です。社内の人が信用して使えるデータがそろっている状態を保つところまでを担当します。データエンジニアという職種の詳しい説明は、用語集のデータエンジニアにあります。
この記事では、データサイエンティストとの違いを含めて、採用するかどうかの判断から、要件の決め方、候補者の探し方と見極め方までを扱います。最終選考の見送り理由をスカウトの対象の条件に加えた支援事例も紹介します。
データエンジニアの採用が必要かどうかを判断する観点
「データを整えてほしい」という依頼だけでは、データエンジニアは何から手をつければよいかを判断できません。採用の前に、社内でデータを使って何を判断したいのかを言葉にしておきます。
集計や抽出を個人の手作業で続けることに限界が来ているかどうかは、次の4つで点検します。
経営や事業の数字を出すたびに、担当者が手作業で集計している
部署ごとに数字の定義が違い、会議で数字が合わない
データサイエンティストや分析の担当者が、データの準備に多くの時間を使っている
機械学習やAIの機能を作りたいが、元になるデータが整っていない
一方で、決まったレポートを作れればよいという段階であれば、分析ツールの導入や、分析を担う人の採用で足りる場合もあります。データの取り込みを任せられる外部のサービスで足りることもあります。基盤の最初の設計だけを業務委託の経験者に依頼し、運用と改善を担う人を正社員で迎える進め方もあります。
社内で最初のデータエンジニアとして迎える場合は、データを使う側の責任者を明確にしておきます。その役の人を置いていない会社では、代表や、事業の数字を見て判断する立場の人が担います。誰がどの数字を使って何を判断するのかが決まっていないと、データエンジニアは何を優先して整えればよいかを判断できません。
データエンジニアとアナリティクスエンジニア・データサイエンティスト・機械学習エンジニアの違い
データエンジニアの近くには、アナリティクスエンジニア、データサイエンティスト、機械学習エンジニアという職種があります。データが生まれてから判断に使われるまでの流れに沿って並べると、それぞれの持ち場が分かれます。
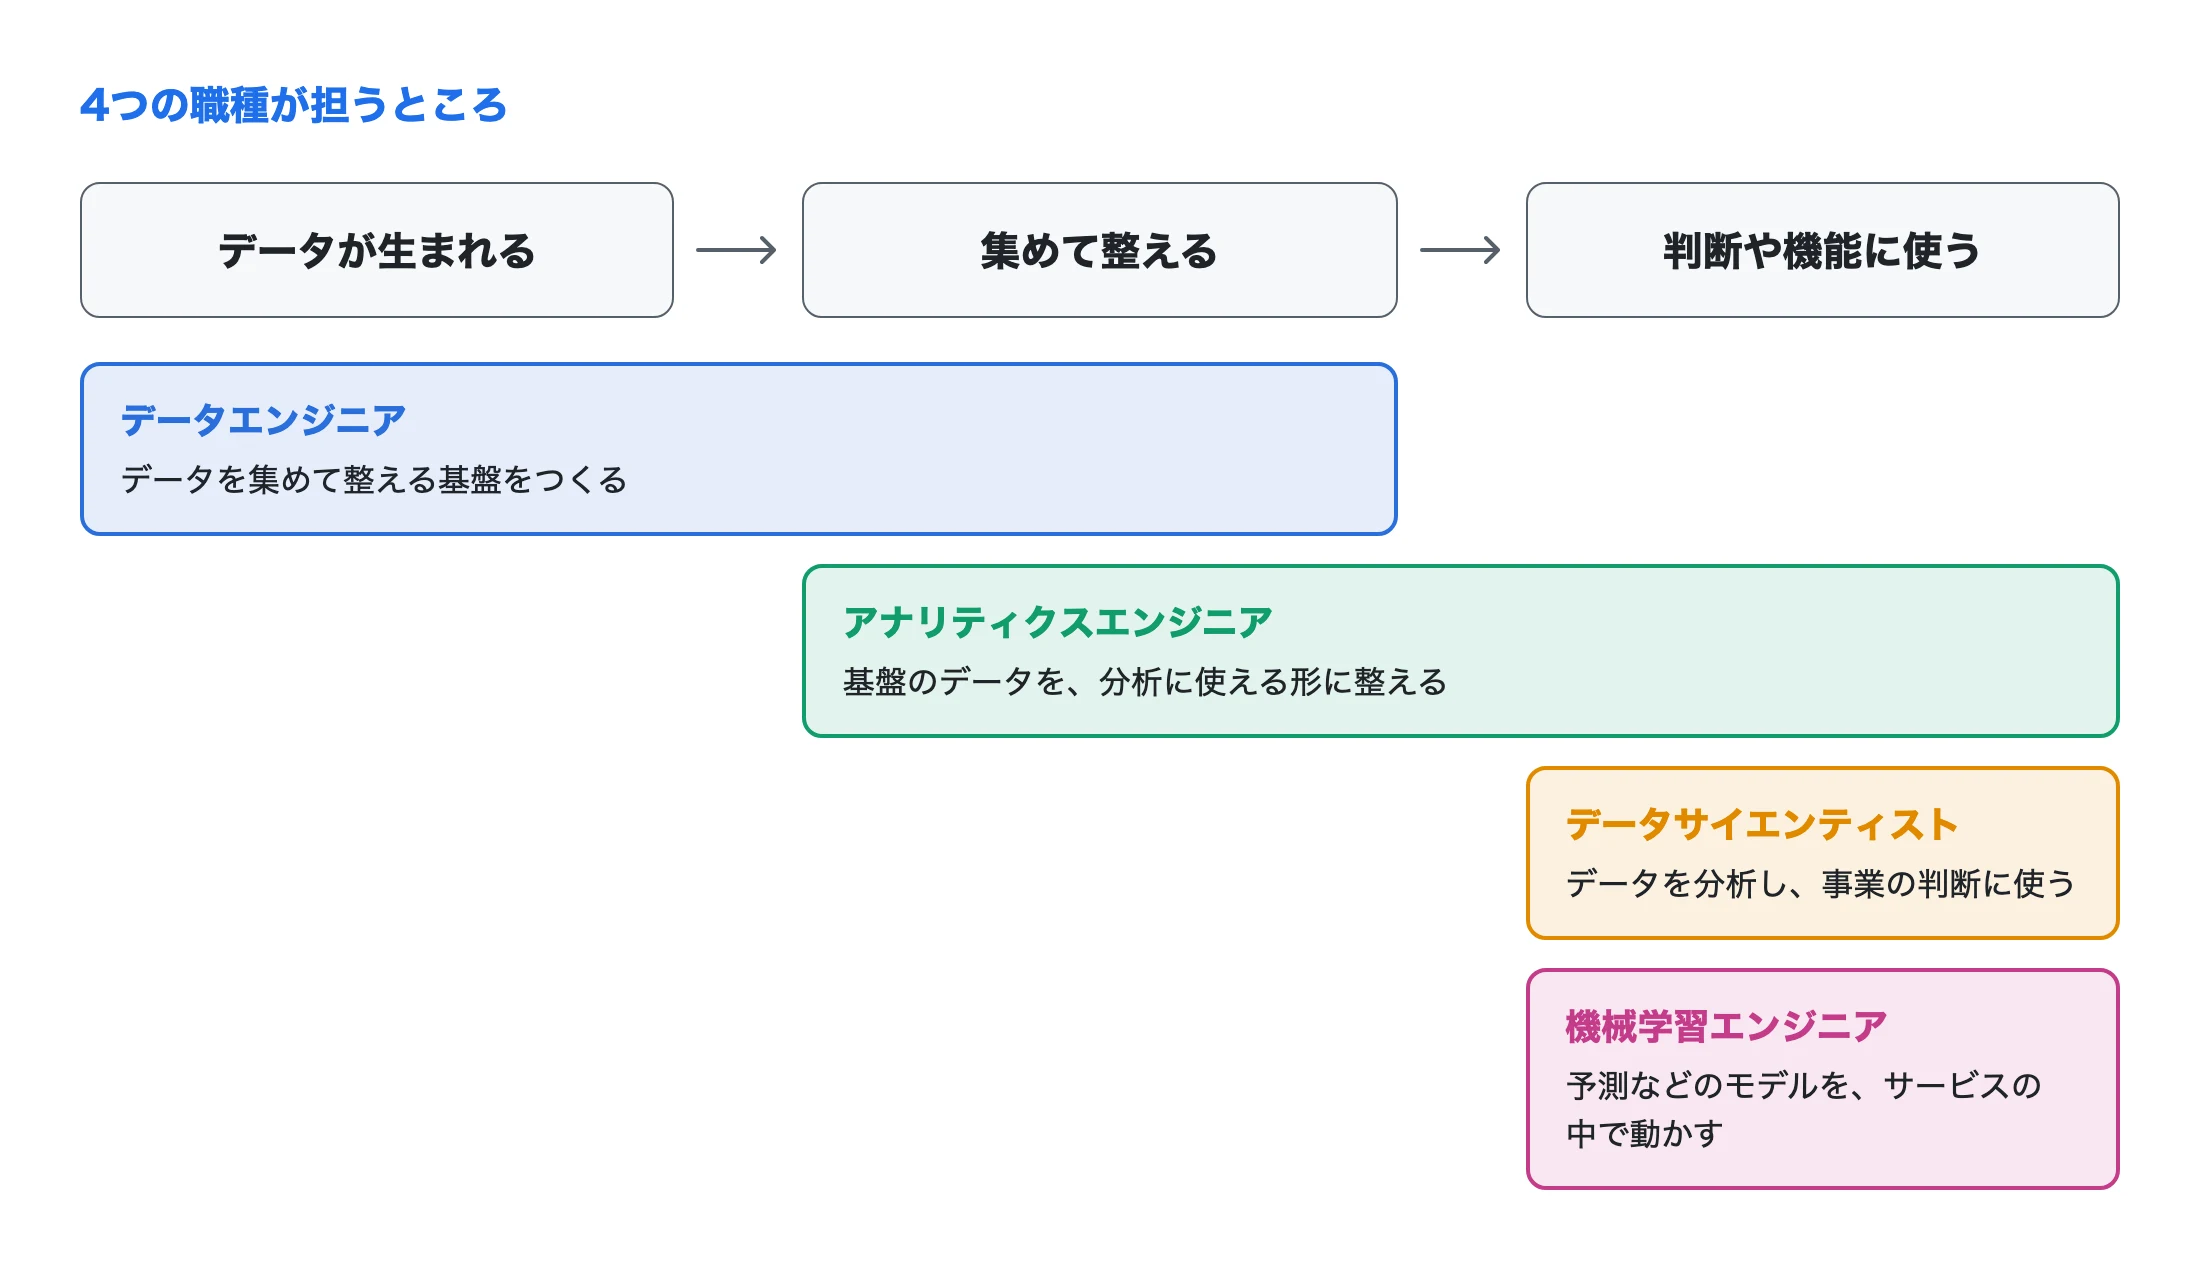
データエンジニアは、サービスや業務システムで生まれたデータを集め、使える状態に整える基盤をつくります。
アナリティクスエンジニアは、基盤に集まったデータを分析に使える形に変換し、社内で数字の定義を統一します。データエンジニアと分析の担当者の間にある仕事を担います。
データサイエンティストは、データを分析して、事業の判断や予測に使える結果を出します。
機械学習エンジニアは、予測などのモデルを、サービスの中で動く仕組みにします。
AIや機械学習に関わる職種の違いは、AIエンジニア・機械学習エンジニア・データサイエンティストの違いでも比べています。採用担当は、この流れのうちどこを任せたいかを先に確認しておくと、求人の職種名を選びやすくなります。
データエンジニアの採用が難しい3つの理由
データエンジニアの採用では、データを扱う人材の不足に加えて、役割の幅と、経験が経歴に表れにくいことが壁になります。
多くの企業で不足するデータを扱う人材
データエンジニアを含むIT人材全体で、求人の数が求職者の数を超える状態が続いています。厚生労働省の一般職業紹介状況(2026年8月分)では、ハローワークを通じた「情報処理・通信技術者」の有効求人倍率(常用、パートタイムを除く)は1.48倍でした(厚生労働省「一般職業紹介状況(令和8年8月分)」参考統計表)。この倍率はIT職全体のもので、データエンジニアに絞った数字ではありません。
データを扱う人材の不足は、企業への調査にも表れています。IPA(情報処理推進機構)の「DX動向2026」では、AI関連の人材の充足状況を尋ねた2025年度の調査で、「データマネジメントの知見があり、社内で企画、推進できる人材」が不足していると答えた企業が71.9%でした(IPA「DX動向2026」、n=1,782)。前年度の同じ項目は73.2%で、不足していると答える企業の割合は高いまま続いています。
データエンジニアに任せたい役割の企業ごとの違い
データエンジニアの求人には、基盤をゼロからつくる仕事も、既存の処理を安定させる仕事も、同じ職種名で書かれています。支援の中で目にしてきたデータエンジニアの求人は、仕事の中身でおおよそ次の4つの型に分かれます。
役割の型 | 主な仕事 | 求人票に出てくる言葉 |
|---|---|---|
基盤の立ち上げ | データを集めて保存する仕組みを、最初から設計してつくる | データ基盤、DWH、データレイク、BigQuery |
データパイプラインの整備 | 各システムからデータを取り込み、加工する処理を安定して動かす | ETL、データパイプライン、ワークフロー |
品質と管理 | データの定義と品質をそろえ、データのアクセス権限を管理する | データマネジメント、データ品質、メタデータ |
機械学習の基盤 | 機械学習やAIの機能に使うデータを整え、届ける。生成AIが社内の文書やデータを検索して回答に使う仕組み(RAG)のために、データの整備と閲覧権限の設計も担う | 特徴量、機械学習用のデータ、AI活用、RAG |
表のDWHは分析のためにデータを集めて保存する仕組み、ETLは各システムからデータを取り出し、加工して基盤に読み込む処理、データパイプラインはその取り込みから加工までの処理をつないだ一連の流れを指します。データレイクは加工する前のデータをそのまま貯めておく場所、BigQueryはDWHとして使われるクラウドのサービスです。メタデータはデータの意味や作成元を説明する情報、特徴量は機械学習のモデルに入力するために加工したデータを指します。
「データ周りを幅広く」とだけ書いた求人では、基盤の立ち上げとデータマネジメントのどちらを任せるのかが書かれておらず、候補者には応募を決める手がかりがありません。
4つの型のうちどれを任せたいかを、1つか2つに絞ります。基盤の立ち上げと品質の管理は、求める経験が大きく異なります。両方を1人に求める場合は、どちらから着手してほしいかを示しておきます。
経歴の一部にしか表れないデータの経験
データエンジニアという職種名を使っていない会社もあり、この肩書きを持つ人は限られます。そのため、バックエンドエンジニアやインフラエンジニア、分析の担当者の肩書きで、仕事の一部としてデータの基盤を扱ってきた人も対象に入ります。
職種名だけで検索すると、対象者は大きく絞られます。一方で、経歴の一部にデータの仕事がある人まで広げると、今度は経験の深さがプロフィールからは読み取りにくくなります。
最終選考の見送り理由をスカウトの対象の条件に加えた支援事例
ある支援先では、データエンジニアの探し方を一度広げたあと、最終選考で見送りになった理由を、スカウトを送る相手を選ぶ条件に加えました。支援先が分からないよう、一部の表現をぼかしています。
支援先の依頼時点の要件
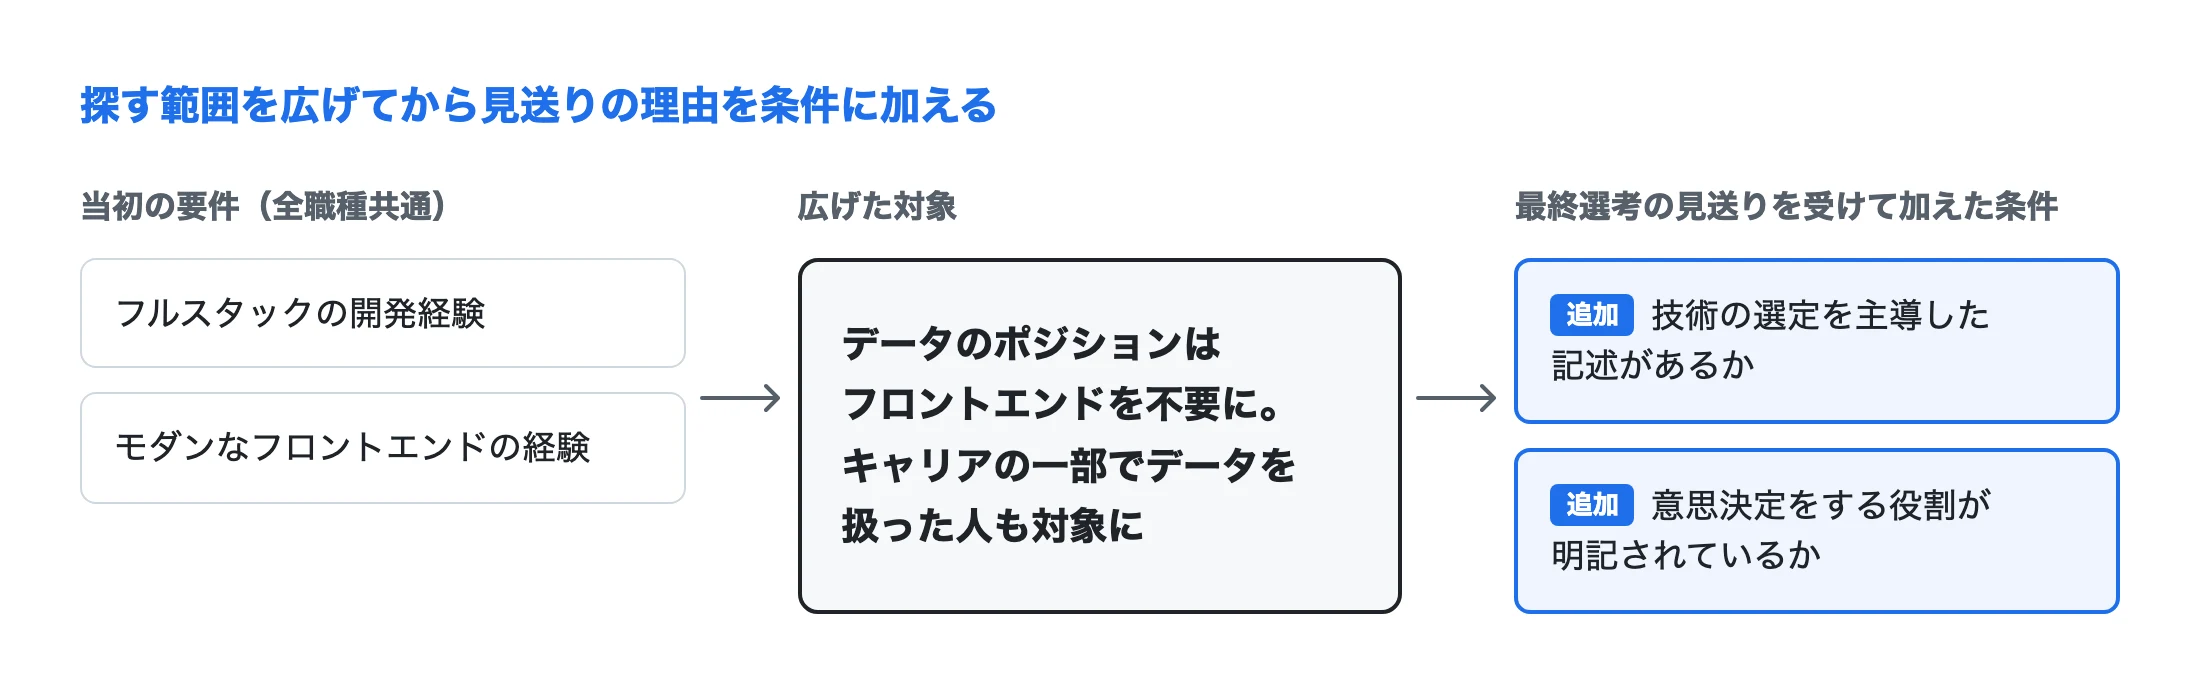
ある支援先では、複数のエンジニアのポジションを同時に募集していました。最初の要件では、フルスタックの開発経験とモダンなフロントエンドの経験を、全職種に共通する条件として求めていました。
要件の見直しで広げた対象
データエンジニアのポジションでは、この共通の条件に合う人がなかなか見つかりませんでした。そこで要件をすり合わせる場で、データのポジションではモダンなフロントエンドの経験を求めないことにしました。
その後の定例では、キャリアの一部でデータを扱ってきた人も対象にしてよい、という判断も先方から共有されました。データエンジニアの肩書きがなくても、仕事の一部でデータの基盤や処理に関わってきた人に声をかけられるようになりました。
最終選考での見送りと分かれ目
対象を広げたあと、スカウトから最終選考まで進んだ候補者がいました。プロジェクトの進め方や、データの管理の成熟度を測る取り組みは、高く評価されました。一方で、次の2点が分かれ目になり、見送りになりました。
技術を選んだ理由を、本人の言葉で説明しきれなかった
意思決定を担った経験が確認できなかった
探す条件に加えたこと
この見送りを受けて、スカウトを送る相手を選ぶ条件に、次の2点を加えました。
技術の選定を主導したことが、経歴に書かれているか
意思決定をする立場の役割が、経歴に明記されているか
対象を広げた条件はそのままにし、そのうえで最終選考の分かれ目になった点を、プロフィールの段階で確かめる形にしました。その後、別の経路から選考に進んだ候補者が内定を承諾し、このポジションは充足しました。
この事例から分かったこと
範囲を広げたことと、見送りの理由をスカウトの対象の条件に加えたことは、どちらか一方では足りないと考えています。データの経験は経歴の一部にしか表れないため、最初は範囲を広げないと候補者が見つかりません。一方で、広げたままでは、最終選考で同じ理由の見送りが続くおそれがあります。
見送りの理由は、選考を担った現場にしか分からないことがあります。採用担当が理由を聞き取り、探す条件の言葉に置き換えておくと、次の候補者を選ぶ段階から観点をそろえられます。この支援先では条件として加えましたが、経歴を簡潔に書く人もいるため、一般には優先して声をかける目印として使うほうが合うと思います。
データエンジニアの役割と要件の決め方
データエンジニアの要件は、BigQueryやdbt(データの変換処理を管理するツール)のようなツール名から書き始めると、どの型の人を探しているのかがぼやけます。要件の出発点は、「入社した人が最初の1年で何を実現すると成功か」に置きます。そこから逆算して、必要な経験を書き出します。ヒアリングの質問の組み立て方は、現場と目線を合わせる要件ヒアリングの設計で紹介しています。求人票の項目ごとの書き方は、求人票のテンプレートと書き方で、見直す前と後の例とあわせて紹介しています。
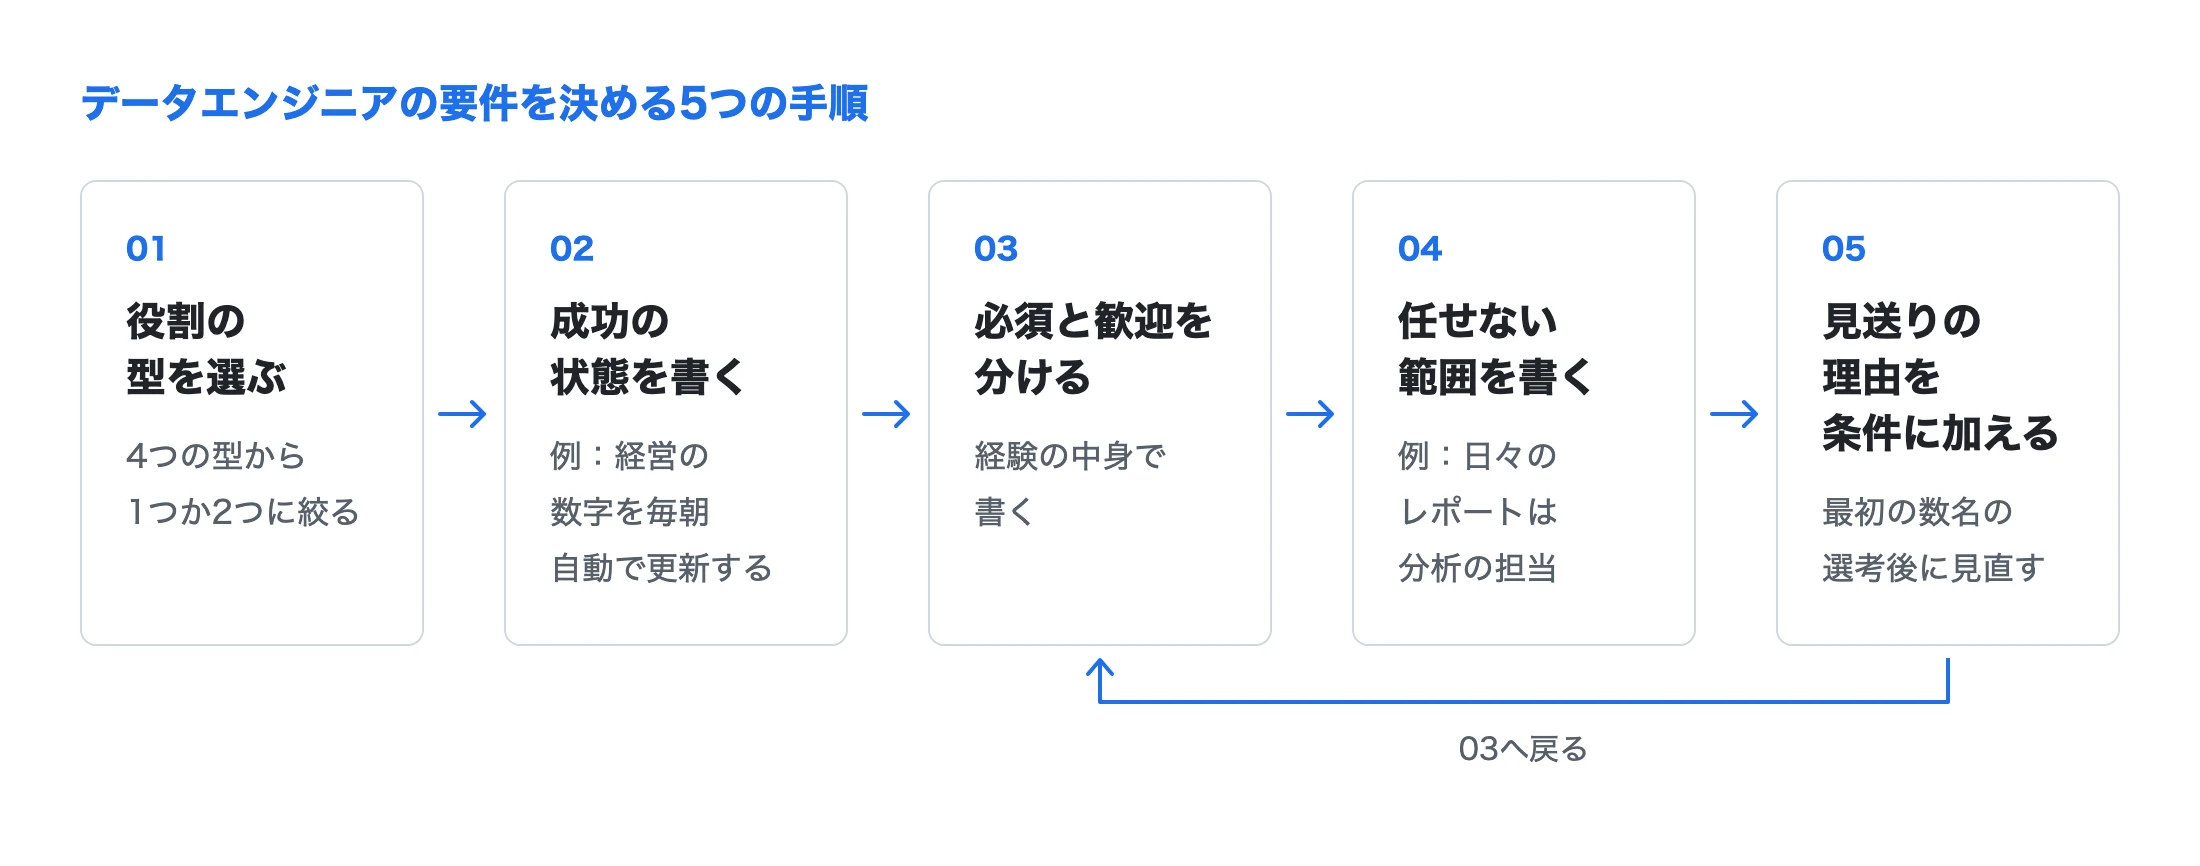
採用担当は、経営や開発責任者(いない会社では、代表や、データを使う部署の責任者)から次の5つを受け取ってから、図の手順で要件を組み立てます。
役割の型
報告先の上長と、成果を評価する人
任せない範囲
入社後1年の成功の状態
年収の範囲
入社後1年の成功の状態
「データ基盤を整えてほしい」だけでは、候補者は何を優先すればよいかを判断できません。「経営会議で使う売上と解約の数字を、手作業なしで毎朝更新される状態にする」「部署ごとに異なる顧客数の定義をそろえ、全社で同じ数字を使えるようにする」のように、誰がどの数字をどう使えるようになるかを書きます。
必須と歓迎の区分と隣接職種の経験の扱い
必須の欄には、成功の状態に照らして、入社してから学んでもらうのでは間に合わない経験だけを書きます。データエンジニアの要件では、データエンジニアとしての経験年数を必須にすると、対象となる候補者は大きく絞られます。
「データエンジニア経験3年以上」より「本番のサービスのデータを取り込み、加工する処理を設計して運用した経験」のように、経験の中身で書くほうが、バックエンドやインフラの肩書きを持つ人も対象に入れられます。
あわせて、技術を選んだ理由を説明できること、意思決定に関わってきたことを、選考で確かめる観点として定めておきます。経歴にその記述がある人は優先して声をかける目印にし、記述がない人は面接で確認します。
任せない範囲の明記
データエンジニアには、データに関わる依頼が集まりやすくなります。日々の集計やレポートの作成を分析の担当者が行うこと、どの数字を見て判断するかを事業の責任者が定めることを求人に書いておけば、基盤づくりに時間を使える環境だと候補者に伝わります。
データエンジニアの求人に書かれた年収の幅
ATS(採用管理システム)で公開している正社員求人のうち、データエンジニアの求人で年収が書かれているもの47件(36社)を、2026年10月に集めて集計しました。対象はスタートアップやIT企業の求人が中心で、同じ会社の求人は3件までにしています。上限の記載がない求人(1件)は、上限の集計から除いています。
求人に書かれた年収 | 下限 | 上限 |
|---|---|---|
4分の1の求人がこの金額以下 | 600万円 | 900万円 |
中央値 | 700万円 | 1,030万円 |
4分の3の求人がこの金額以下 | 800万円 | 1,200万円 |
求人の年収の幅は募集の段階で示す範囲で、内定時の提示額は選考を経て個別に算出されます。データエンジニアの求人には固定残業代を年収に含める会社もあるため、比べるときはその有無を確認します。基盤の立ち上げとデータパイプラインの運用では上限の金額で任せる仕事が異なるため、自社の範囲には上限で迎える人に任せる型を添えて書きます。
見送りと通過の理由をもとに探す条件を見直す日の設定
最初の数名の選考が進んだ時点で、現場から見送りや通過の理由を聞き、探す条件を見直す日をあらかじめ設定しておきます。最終選考で分かった観点を、スカウトで優先して声をかける目印に加えておくと、同じ理由の見送りが続くことを防ぎやすくなります。
データエンジニアに魅力を伝える方法
データエンジニアの候補者は、自分が整えたデータが誰のどんな判断に使われるのか、技術を選ぶ裁量がどこまであるのかを気にします。技術名の一覧より、データのいまの状態と使われ方を書くほうが、入社後の仕事を想像してもらいやすくなります。送れる相手の数が限られる職種なので、1通ごとに伝える情報の選び方が返信の数を左右すると思います。
データエンジニアの候補者に伝わる情報
スカウトの文面と求人票で伝えたい情報は、次のとおりです。
伝える情報 | 書く内容 |
|---|---|
データの使われ方 | 社内の誰が、どのデータを使って、何を判断しようとしているか |
データの状態 | データがどこに散らばっていて、何が手作業になっているか |
任せる範囲 | 基盤の立ち上げか、既存の基盤の整備か |
技術を選ぶ判断 | 技術を選ぶ判断を、誰がどこまで持つか |
扱うデータ | 扱うデータの種類と量、個人情報を含むか、データのアクセス権限の管理の状態 |
体制と働き方 | データの専任は何人いるか、相談相手は誰か、夜間に処理が止まったときの対応の有無 |
データの状態が整っていなければ、そのまま書きます。「売上の数字は、いまも毎週担当者が複数のシステムから手作業で集めています」と書けば、基盤を立ち上げたい人には、入社後の仕事が具体的に伝わります。
データエンジニアの候補者の探し方
データエンジニアを探すときは、肩書きの外まで対象を広げます。バックエンドエンジニア、インフラエンジニア、アナリティクスエンジニア、分析の担当者として、仕事の一部でデータの基盤や処理を担ってきた人もいるためです。
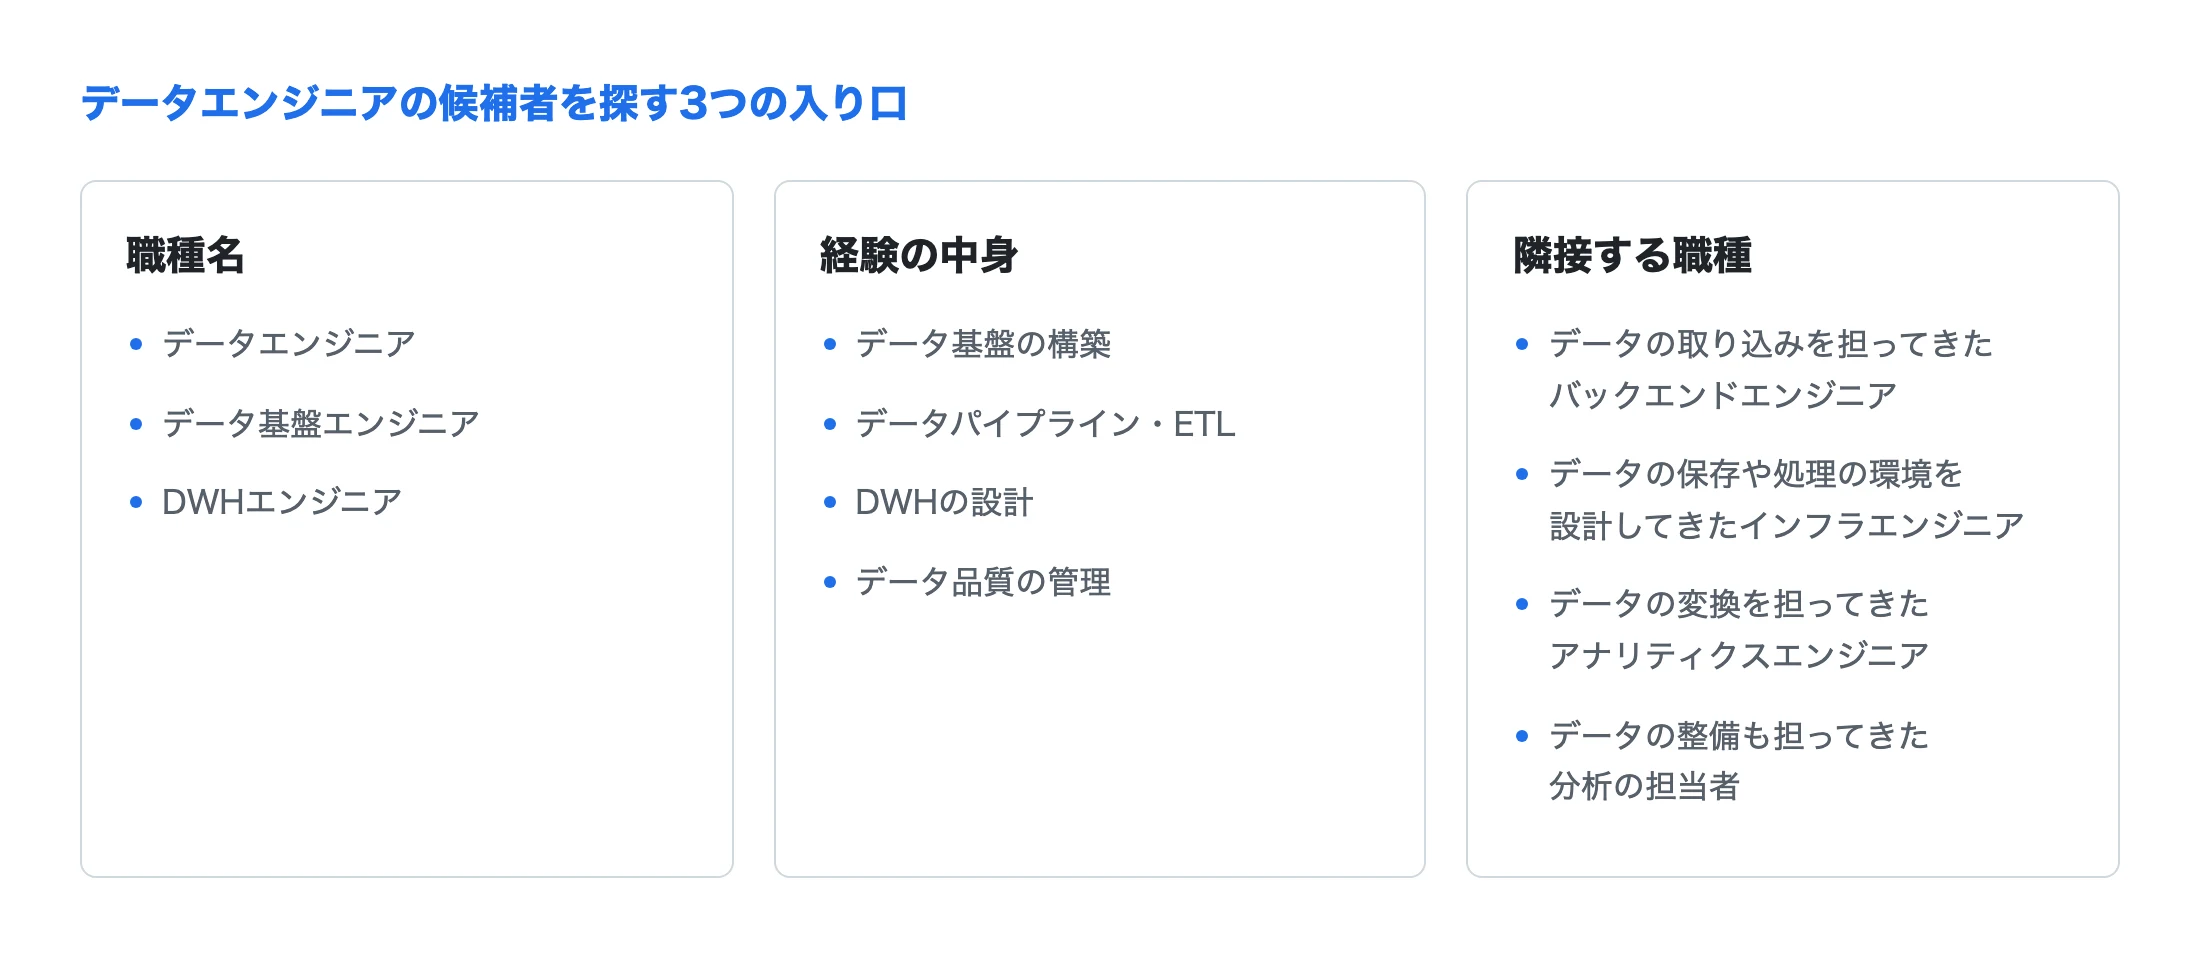
職種名で探す場合は、データエンジニアのほか、データ基盤エンジニアやDWHエンジニアの肩書きを持つ人が対象になります。対象は明確ですが、数は限られます。
経験の中身で探す場合は、「データ基盤の構築」「データパイプライン」「ETL」「DWHの設計」「データ品質の管理」のような言葉を手がかりにします。BigQuery、Snowflake(BigQueryと同じ種類のサービス)、dbt、Airflow(処理を決まった順と時刻に動かすツール)のようなツール名も、経歴に表れやすい言葉です。ツール名は使ってきた環境を示すもので、経験の深さはプロフィールの記述や面接で確認します。
隣接する職種では、サービスのデータの取り込みや集計の処理を担ってきたバックエンドエンジニア、クラウドでデータの保存や処理の環境を設計してきたインフラエンジニア、データの変換を担ってきたアナリティクスエンジニア、分析のためのデータの整備も担ってきた分析の担当者が対象になります。
媒体は、任せたい型に合わせて選びます。基盤の立ち上げや品質と管理の型ならデータ基盤の経験者が多い媒体、データパイプラインの整備の型ならバックエンドやインフラの経験者が多い媒体から優先して使います。「dbt」「データパイプライン」のような型を表す言葉で各媒体を検索し、該当する人数を比べると、相性を確認できます。
データエンジニアの候補者の見極め方
データエンジニアの見極めでは、使った技術の数より、技術を選んだ理由と、データを使う人のことを考えてきたかを見ます。媒体のプロフィールと職務経歴書では技術の選定や意思決定の記述を目印にし、記述の有無にかかわらず、判断の中身は面接で確認します。カジュアル面談は自社のデータの状況を知ってもらう機会と考え、合否の判断とは切り離します。候補者からはデータの量や使っているツールについての質問が出やすいので、カジュアル面談の前に開発責任者と答えを確認しておきます。書類選考で通す・保留・見送りの基準を表にまとめる方法は、書類選考の判定表の作り方で紹介しています。
選考を通して確認することの例
選考を通して確かめたいことは、マインド・姿勢と、経験・スキルの2つの領域に分かれます。担当してきたデータの基盤を題材に、本人が担った範囲と、判断の理由を分けて話してもらいます。
マインド・姿勢では、データを使う人からの急ぎの依頼と基盤づくりの間で、どう優先をつけるかを確認します。データの状態への問題意識もあわせて確認します。
質問の例 | 答えから確認すること |
|---|---|
データを使う人から急ぎの集計を頼まれたとき、基盤づくりの作業との優先をどうつけたいと考えますか | 目先の依頼と基盤の改善の優先のつけ方 |
前の職場のデータ基盤で、自分なら最初に直したいと感じていた箇所はどこですか | いまの基盤の問題を自分で見つけてきたか |
経験・スキルでは、データエンジニアならではの5つの場面で、技術の判断の中身を確認します。
質問の例 | 答えから確認すること |
|---|---|
データを集めて蓄える仕組みを選んだとき、何と比べ、何を理由に選びましたか | 比較の軸を持って基盤の技術を選んできたか |
データを使う人から「数字が合わない」と言われたとき、どこまで遡って原因を調べ、何を変えましたか | 数字のずれの原因を上流まで調べてきたか |
データの取り込みや集計の処理が止まったとき、どう気づき、どう復旧し、再発をどう防ぎましたか | 止まったことに監視で先に気づく仕組みにし、再実行しても結果が重複しない形(冪等性)に改善したか |
分析や機械学習の担当から相反する要望が出たとき、何を基準に優先しましたか | 相反する要望を基準を持って優先してきたか |
AIが書いた変換処理を本番に入れる前に、データのテストで何を確かめる決まりにしていましたか(AIを使っていない場合は、人が書いた処理での決まりで構いません) | 件数や重複、定義のずれを、処理を書いた人に頼らず検査できる形にしていたか |
答えの深さは、同席する現場のエンジニアが評価します。
現場の同席と内定前の合意
選考のうち1回は、現場のエンジニアに同席してもらいます。データを扱えるエンジニアが社内にいない会社に向けて、社外の経験者に面接を頼む進め方を、後の「社内にデータの経験者がいない場合の見極め」の節にまとめています。
面接の前に、人事が記入シートを用意し、同席するエンジニアに共有しておきます。観点は2〜3個に絞り、所見を書く欄とあわせてシートに載せます。データエンジニアでは、技術を選んだ理由の説明、意思決定に関わった範囲、データの品質への向き合い方を観点に入れます。
データを使う側の責任者にも、選考のどこかで話してもらいます。候補者は、自分の仕事が誰の判断につながるかを確認できます。
面接後に提出された所見をもとに、人事が次の選考に進めるかを決定します。そのうえで、直属の上長や経営が最終面接で採用の可否を判断します。
内定を出す前に、任せる範囲と任せない範囲、夜間に処理が止まったときの対応の有無を候補者と合意します。合意した内容は、求人票や労働条件通知書の記載と照らし合わせておきます。
社内にデータの経験者がいない場合の見極め
バックエンドやインフラの責任者がいれば同席してもらい、技術を選んだ理由の筋道と、障害や誤りへの向き合い方に絞って確認します。データの専門性まで深く確認したいときは、社外の経験者に1回だけ面接を依頼する方法もあります。
依頼の前に、業務委託の契約と守秘の取り決めを結びます。社外の方に書いてもらうのは所見までで、合否は自社で判断します。候補者には社外の方が同席することを事前に伝え、渡す経歴は選考に必要な範囲にとどめます。面接のあとは、渡した経歴書の削除か返却をお願いします。
エンジニアの責任者もいない会社では、代表や一人で人事を担う人が、要件づくりから選考までを受け持ちます。手始めに、経営会議や日々の業務で手作業で集めている数字を書き出し、入社1年後にどの数字が自動で更新されていれば成功かを設定します。この成功の状態を社外のデータエンジニアの経験者に見せ、必要な経験の書き出しと面接への同席を頼みます。
データエンジニアの採用でよくある質問
データエンジニアとデータサイエンティストは別々に募集したほうがよいですか
データエンジニアはデータ基盤やデータパイプラインの設計と運用、データサイエンティストは統計や機械学習を使った分析が仕事の中心です。面接への同席も、データエンジニアにはデータ基盤を担う現場のエンジニアに、データサイエンティストには分析の実務経験がある社員に依頼します。データエンジニアとデータサイエンティストの求人は分けて出します。2つの求人の業務内容と労働条件は、職種名どおりの仕事の実態に合わせます。
データエンジニアの経験者が見つからないときはどうすればよいですか
経験の中身で要件を書き直し、職種名の異なる候補者も対象に入れます。キャリアの一部でデータの基盤や処理を担ってきたバックエンドエンジニアやインフラエンジニアが対象になります。そのうえで、技術を選んだ理由を説明できるか、意思決定に関わってきたかを、選考で確認します。
1人目のデータエンジニアにはどんな人が向いていますか
最初の1人は、基盤をつくる技術に加えて、データを使う人の要望を聞き、何から整えるかを自分で判断してきた経験がある人が向いていると思います。社内にデータの専門家がいない段階では、技術の選定を本人に任せることになるためです。
技術が分からない採用担当でも見極められますか
どの技術を選ぶべきだったかという判断の良し悪しは、技術が分からない採用担当には評価が難しいところです。それでも、経歴に「データの基盤を3年間運用した」「dbtでデータの変換処理を組んだ」のような記述があるかどうかは、採用担当が確認できます。
こうした記述の有無を、開発責任者と合意した基準に照らせば、スカウトを送るかと書類選考を通すかは採用担当が判断できます。技術の選定に関わってきたか、データを使う人の要望を受けて基盤を改善してきたかは、面接で本人に聞きます。
データエンジニアの採用に困ったら
データエンジニアの採用がうまく進まないときは、候補者が集まらないのか、選考で見送りが続くのかを分けて確認します。採用までに時間がかかる場合は、その間に基盤の仕事を誰が担うかもあわせて決定しておきます。
困っていること | まず見直すこと | 参考になる記事・節 |
|---|---|---|
何人に声をかければ充足するかの見当がつかない | 充足したい時期から、最終選考まで進む人数と必要な返信の数を見積もっているか | |
求人を出しても応募が少ない | データの使われ方と、いまどこが手作業になっているかを求人に書いているか | この記事の「データエンジニアの候補者に伝わる情報」 |
人材紹介のエージェントから推薦が来ない | データサイエンティストとは違う職種であることと、基盤の立ち上げか既存の基盤の整備かを担当者に伝えているか | |
肩書きで探すと対象者が少なすぎる | データの基盤や処理を担ってきたバックエンドやインフラの経験者にも、スカウトの対象を広げているか | この記事の「データエンジニアの候補者の探し方」 |
最終選考で見送りが続く | 見送りの理由を現場から聞き取り、スカウトで優先して声をかける目印に加えているか | この記事の「最終選考の見送り理由をスカウトの対象の条件に加えた支援事例」 |
専任のデータエンジニアがなかなか採用できない | 採用できるまでの間、データの取り込みの設定や、定例のレポートに使う集計処理の作成を、業務委託のデータエンジニアや開発会社に任せられないか。任せる場合は、どの数字の定義を全社で使うかや、誰にどのデータの閲覧を許すかといった判断を社内の誰が行うかと、採用した社員への引き継ぎの方法を先に決めているか | この記事の「データエンジニアの採用が必要かどうかを判断する観点」 |
見直す段階を一つに絞りきれないときは、お問い合わせからご相談ください。直近の見送りの理由が分かる選考の記録があれば、それをもとに探す条件の見直しから一緒に進めます。
永井涼平
HRdev代表
レバレジーズ、クラウドワークス等を経て2021年にHRdev創業。18年以上エンジニア採用の最前線に立ち、ログラス・MFS・SALESCORE等の支援実績を持つ。